1.RAG基础
1.1.RAG是什么
RAG(Retrieval-Augmented Generation,检索增强生成) 是一种让大语言模型(LLM)"边查资料边回答"的技术范式。
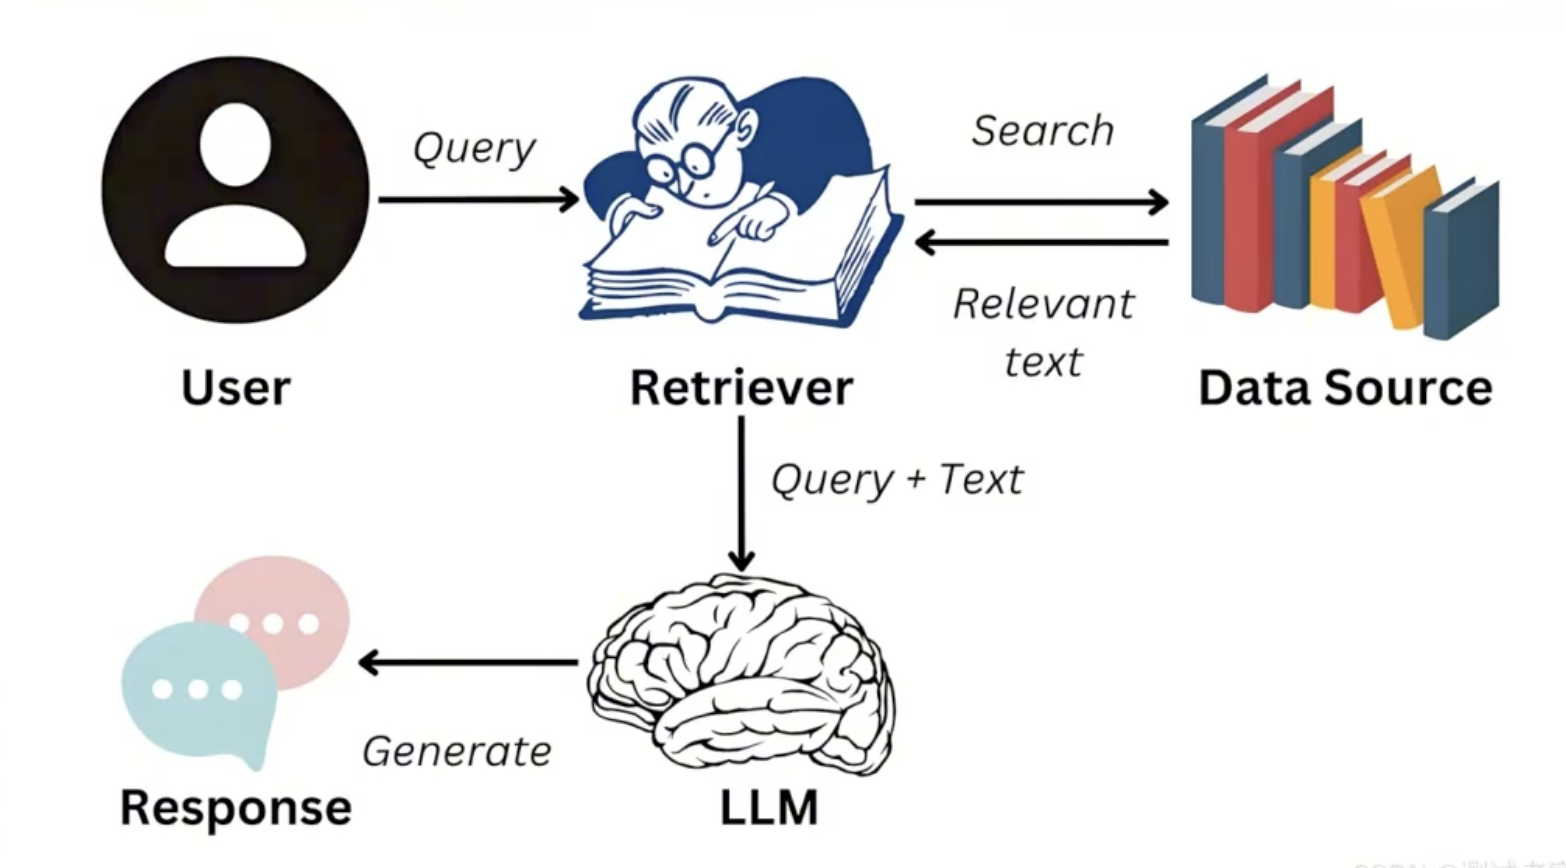
如果没有RAG,则User直接访问大模型,大模型生成Response。有了RAG,retriever将检索到的信息和User的问题组合发送给大模型,然后大模型再生成Response。
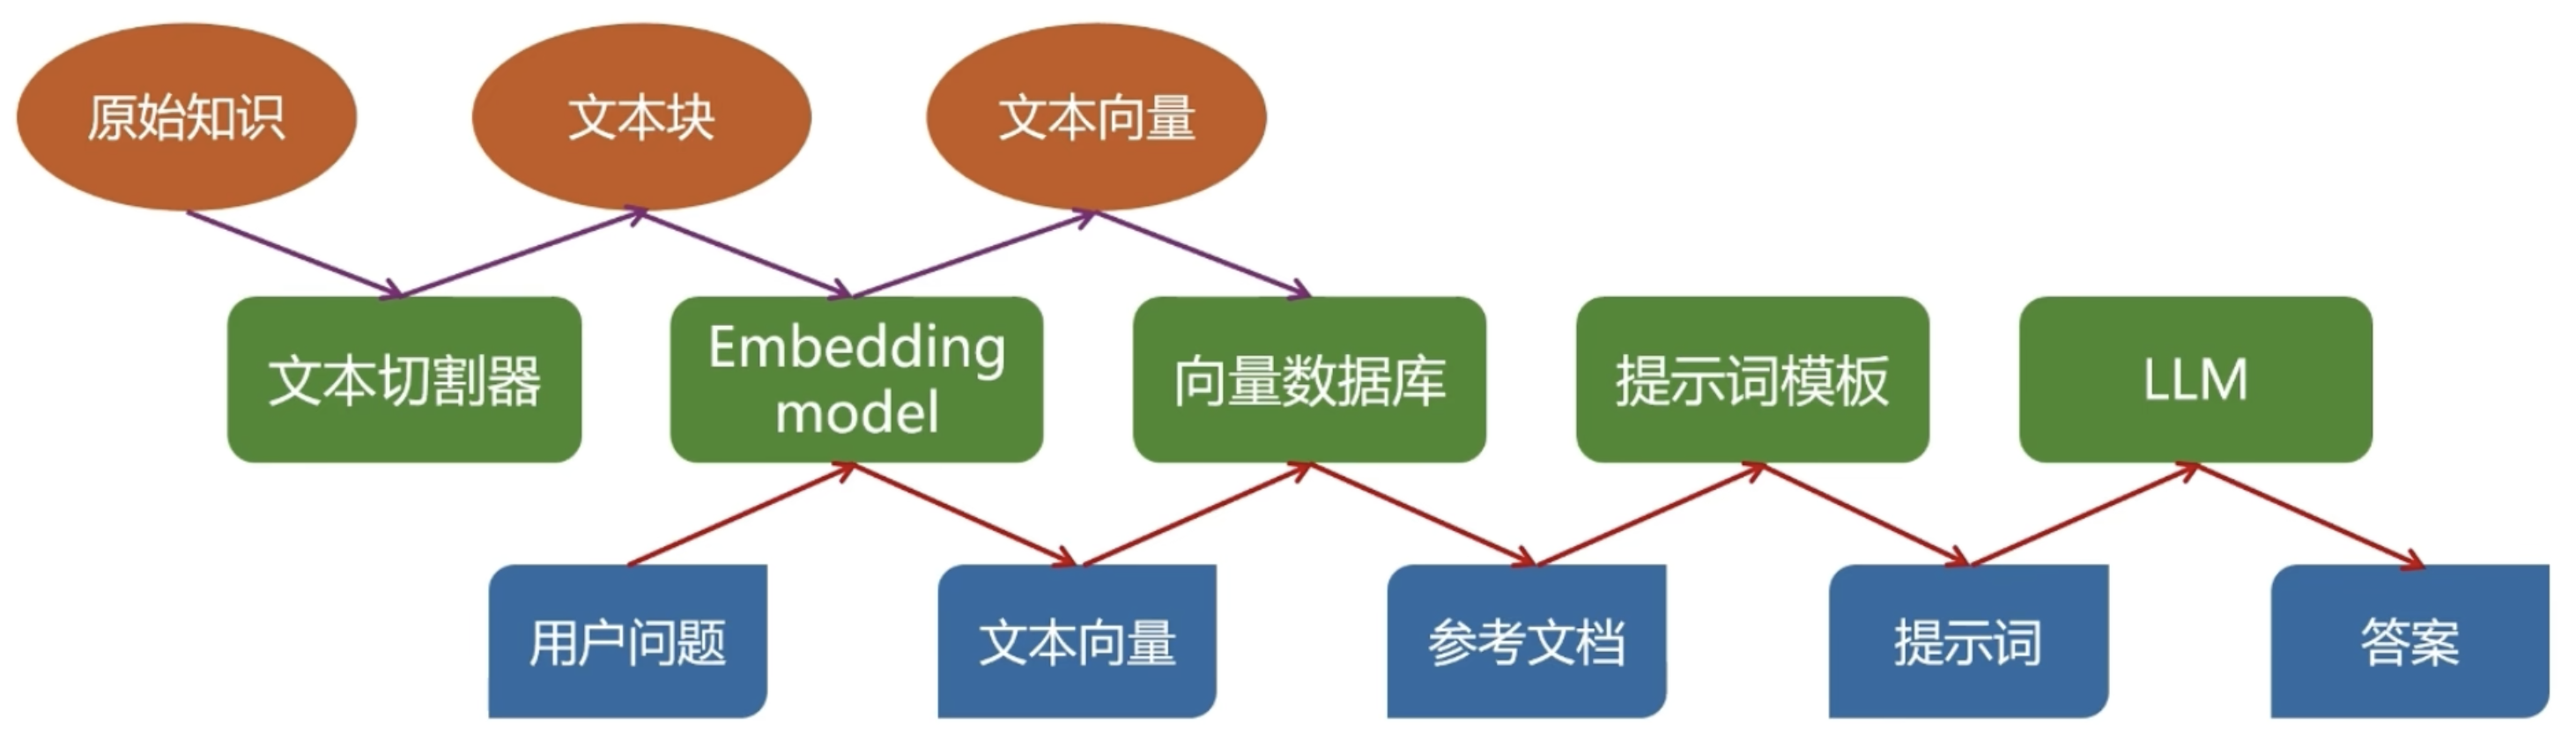
RAG由两部分组成:
检索模块:在知识库中检索与当前输入问题相关的文档或片段。
生成模块:基于检索结果和原始输入,通过大模型生成准确、丰富的回答
1.2.为什么需要RAG
大模型有"知识截止日期"和"幻觉"两大问题:它只能基于训练时的知识回答,且容易一本正经地编造。具体局限如下:
(1)知识过时 (无法知道训练数据之后的事件)
(2)幻觉问题(编造看似合理但错误的信息)
(3)缺乏特定领域知识 (如公司内部文档、专业数据库)
1.3.RAG是怎么去解决问题的
RAG 的解法是:回答之前,先从外部知识库检索出相关资料,再把资料作为上下文喂给模型,让模型基于这些"证据"生成答案。
换句话说,把"检索(找到相关资料)"和"生成(LLM 写答案)"结合起来,用外部知识增强模型的生成能力。
具体问题点如下:
(1)知识陈旧:实时检索最新资料,不必重训模型
(2)幻觉(编造):基于检索到的证据回答,答案可溯源
(3)私有/领域知识:把企业内部、私有数据接入,而不用泄露给模型训练
(4)可解释/可验证:能指出答案来自哪段文档
(5)成本:相比微调/重新训练,RAG 更轻量、易更新
1.4.RAG基本工作流程
涉及RAG的三个流程如下:
(1)离线建库(Indexing)
把文档(PDF、网页、数据库、代码等)切分成小块(chunk);
用 embedding 模型把每块转成向量;
向量存入向量数据库/索引(如 LanceDB、Milvus、FAISS、Pinecone 等)。
(2)在线查询(Retrieval)
用户提问 → 用同一个 embedding 模型把问题转成向量;
在向量库中做相似度检索,找到最相关的 Top-K 个文档块(也常结合关键词/全文/混合检索)。
(3)增强生成(Generation)
把检索到的资料和用户问题拼成一个 prompt;
交给 LLM 生成最终答案,通常要求模型"只依据给定资料回答"。
2.RAG原理
2.1.文档分割
核心:语义连贯性
(1)应尽量保证划分后的同一段文本里面,语义是统一、完整的
(2)太长语义不统一,影响检索效果
(3)太短语义不完整,影响回答质量
文档分割方法如下:
2.2.文档向量化
通过向量模型将文本转化为向量的过程。
2.3.倒排索引和KNN
文本快速搜索,一般使用倒排索引。
倒排索引是一种常见的向量数据库索引结构,用于快速定位与查询向量相似的数据项。它通过构建一个映射将每个向量的特征值与包含该特征值的向量关联起来。当查询一个向量时,可以通过倒排索引快速找到包含相似特征值的向量。
KNN-K Nearest Neighbor
KNN 搜索叫做 K 近邻搜索将查询语句转换为向量,然后再求该向量与数据库中的向量相似度最高,距离最近的向量集。
暴力搜索也称穷举搜索,是最直接的方法,通过计算查询向量与数据库中每一个向量的距离,来评估向量之间的相似程度, 最终算法会选择距离最近的k个数据点,作为查询向量的最近邻居 K-nearest-neighbor简称KNN
2.4.ANN和聚类索引
ANN全称为Approximate nearest neighbor search
ANN算法的核心思想是权衡检索的精度与效率,通过牺牲一部分精度,来显著提升搜索的速度通过构建专门的索引结构 ndex,ANN算法能够有效的缩小搜索空间,而不是对整个数据库进行全面的比较,从而快速定位到与查询向量近似的结果。
基本思想是提前计算 Vector Embedding之间的相似度,把相似的向量组织在一起,方便以后找到相似的向量。
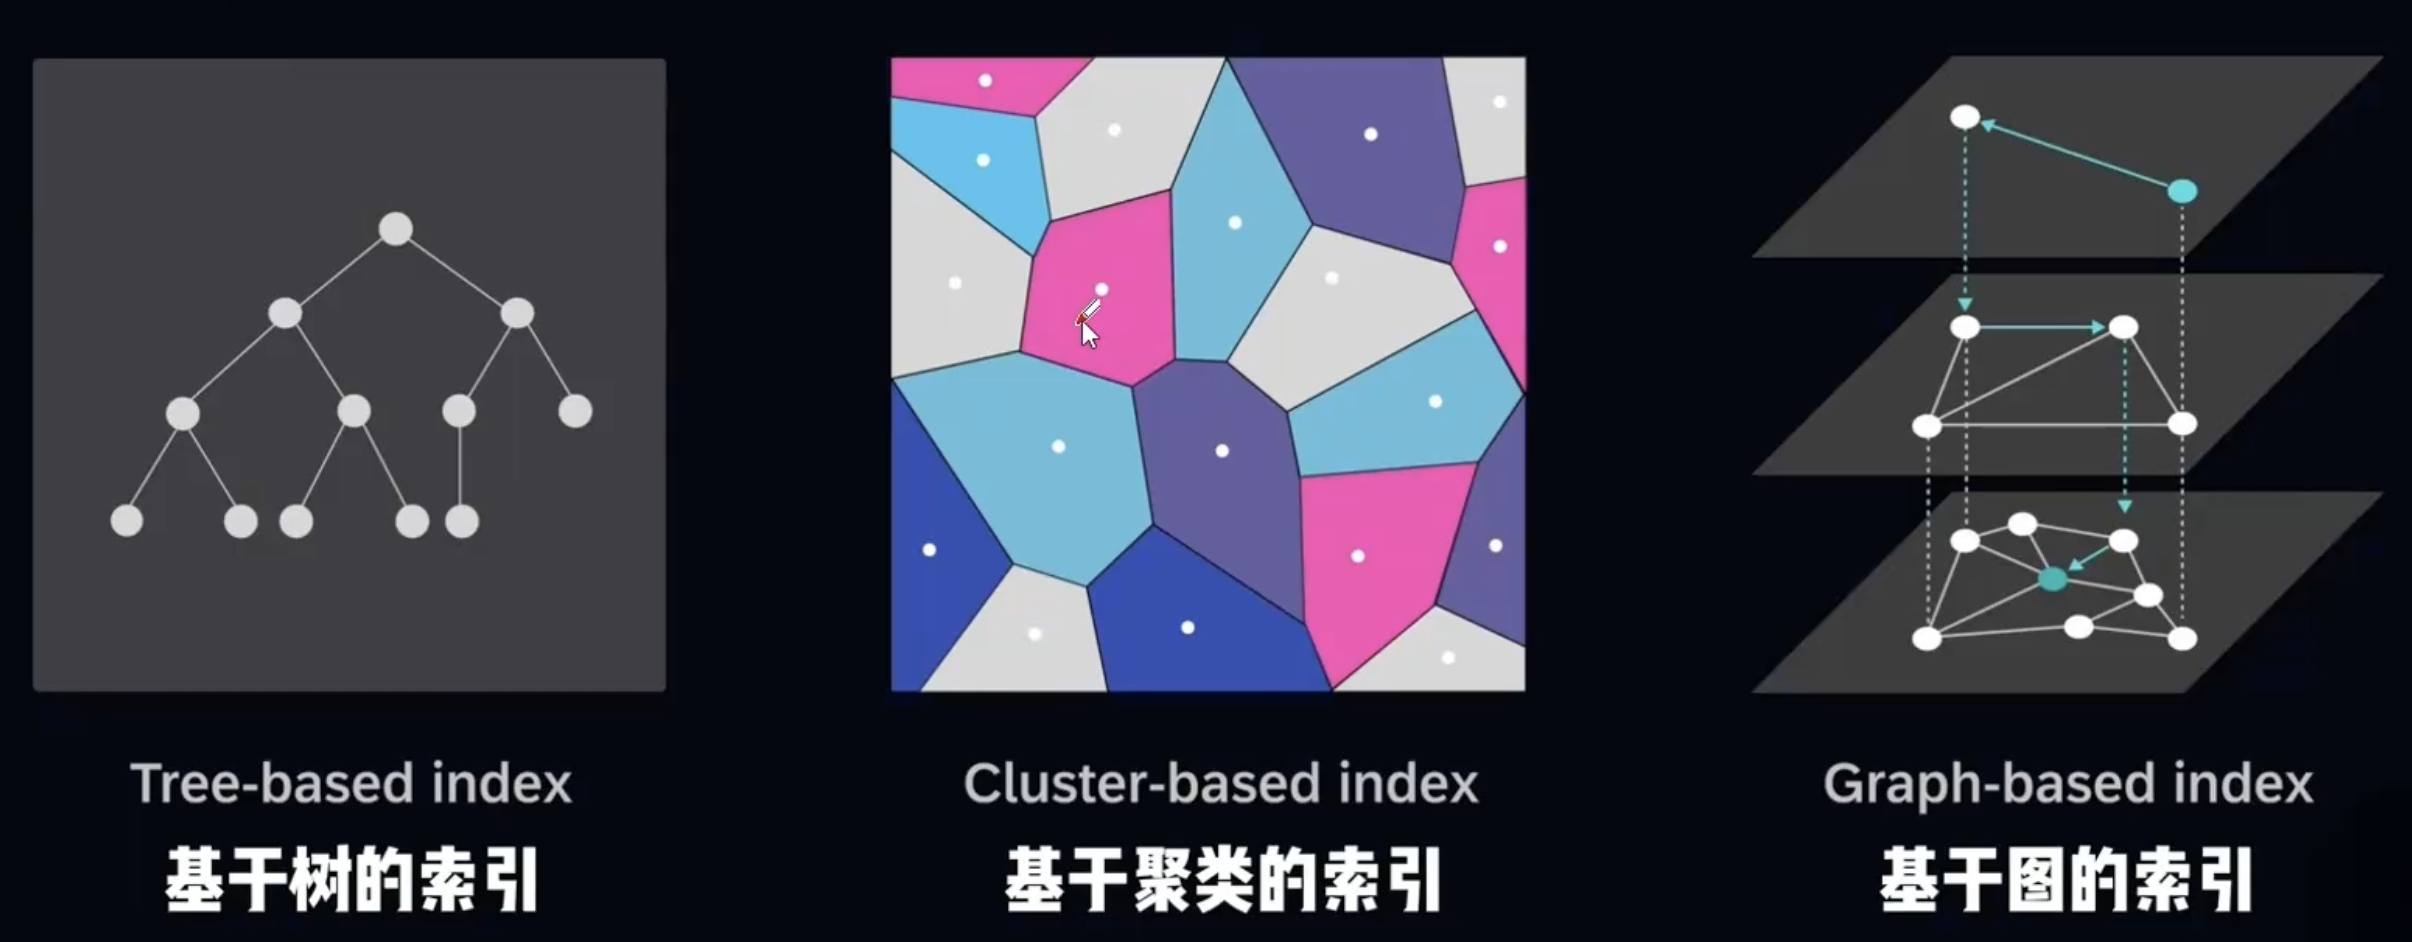
ANN算法实现有三种方案:
欧式距离也称欧几里得距离,是最常见的距离度量,衡量的是多维空间中两个点之间的绝对距离。
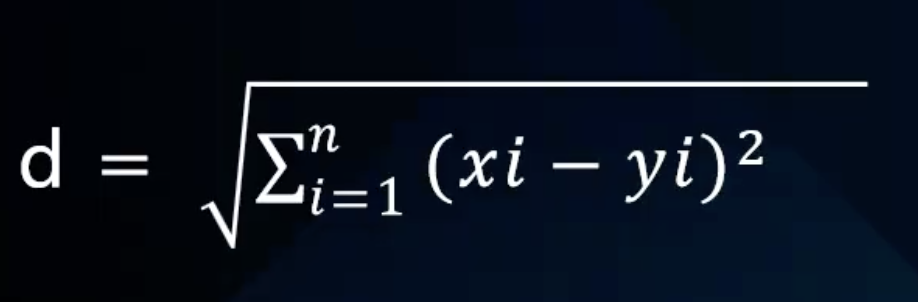
2.5.PQ乘积向量化
Product Quantization
一个1024维的向量有多大呢?
向量一般使用单精度浮点数来表示
一个单精度浮点数占32位 (bit),一个双精度浮点数占64位 (bit)
1Byte (字节) =8bit (位)
1024*32/8=4096个字节=4kb
(1)向量化过程
如下图所示
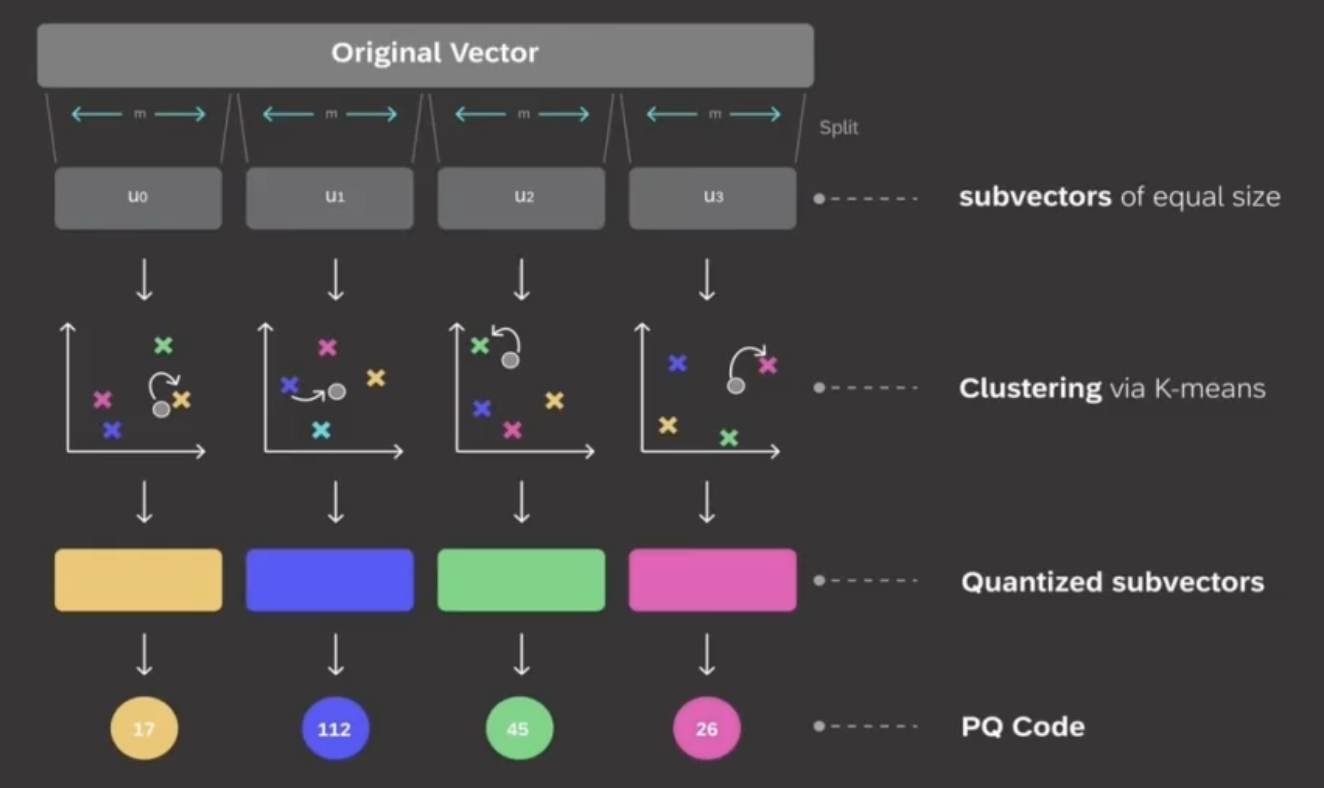 subvectrs of equal size:将原始向量分成等长向量。比如1024维向量,分成8段,那每一段就是一个128维的向量。
clustering via K-means:通过聚类算法,把每一段分成256个空间,并计算出每个空间的中间向量值。
quantized subvectors:计算子向量属于同段向量的哪个空间。
PQ Code:输出对应空间的中间向量值(整数,0~255,8bit表示,或1Byte)。这里,一个1024维的浮点数原始向量(4kB)就转化为了一个8维的整数向量(8Byte),空间压缩到了1/512。
3.RAG优化方法
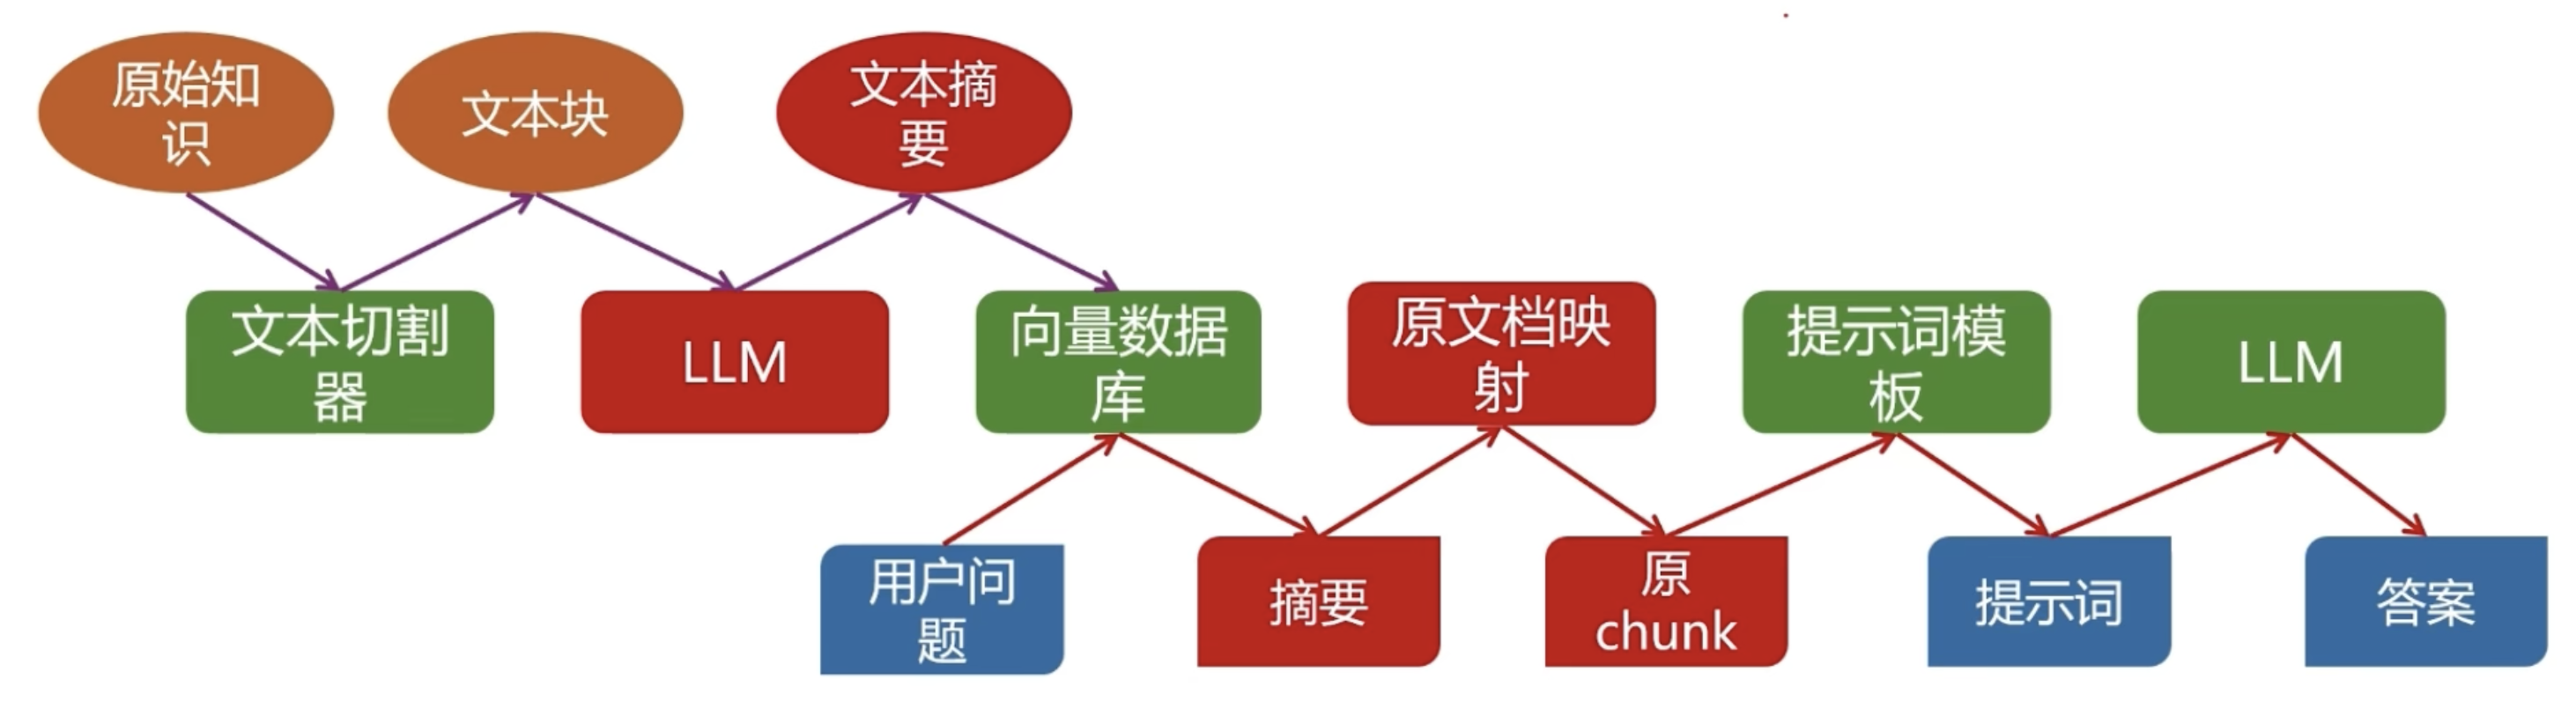
3.1.检索优化——small to big
如果要通过检索小文本,并生成大文本,可以使用以下检索优化。
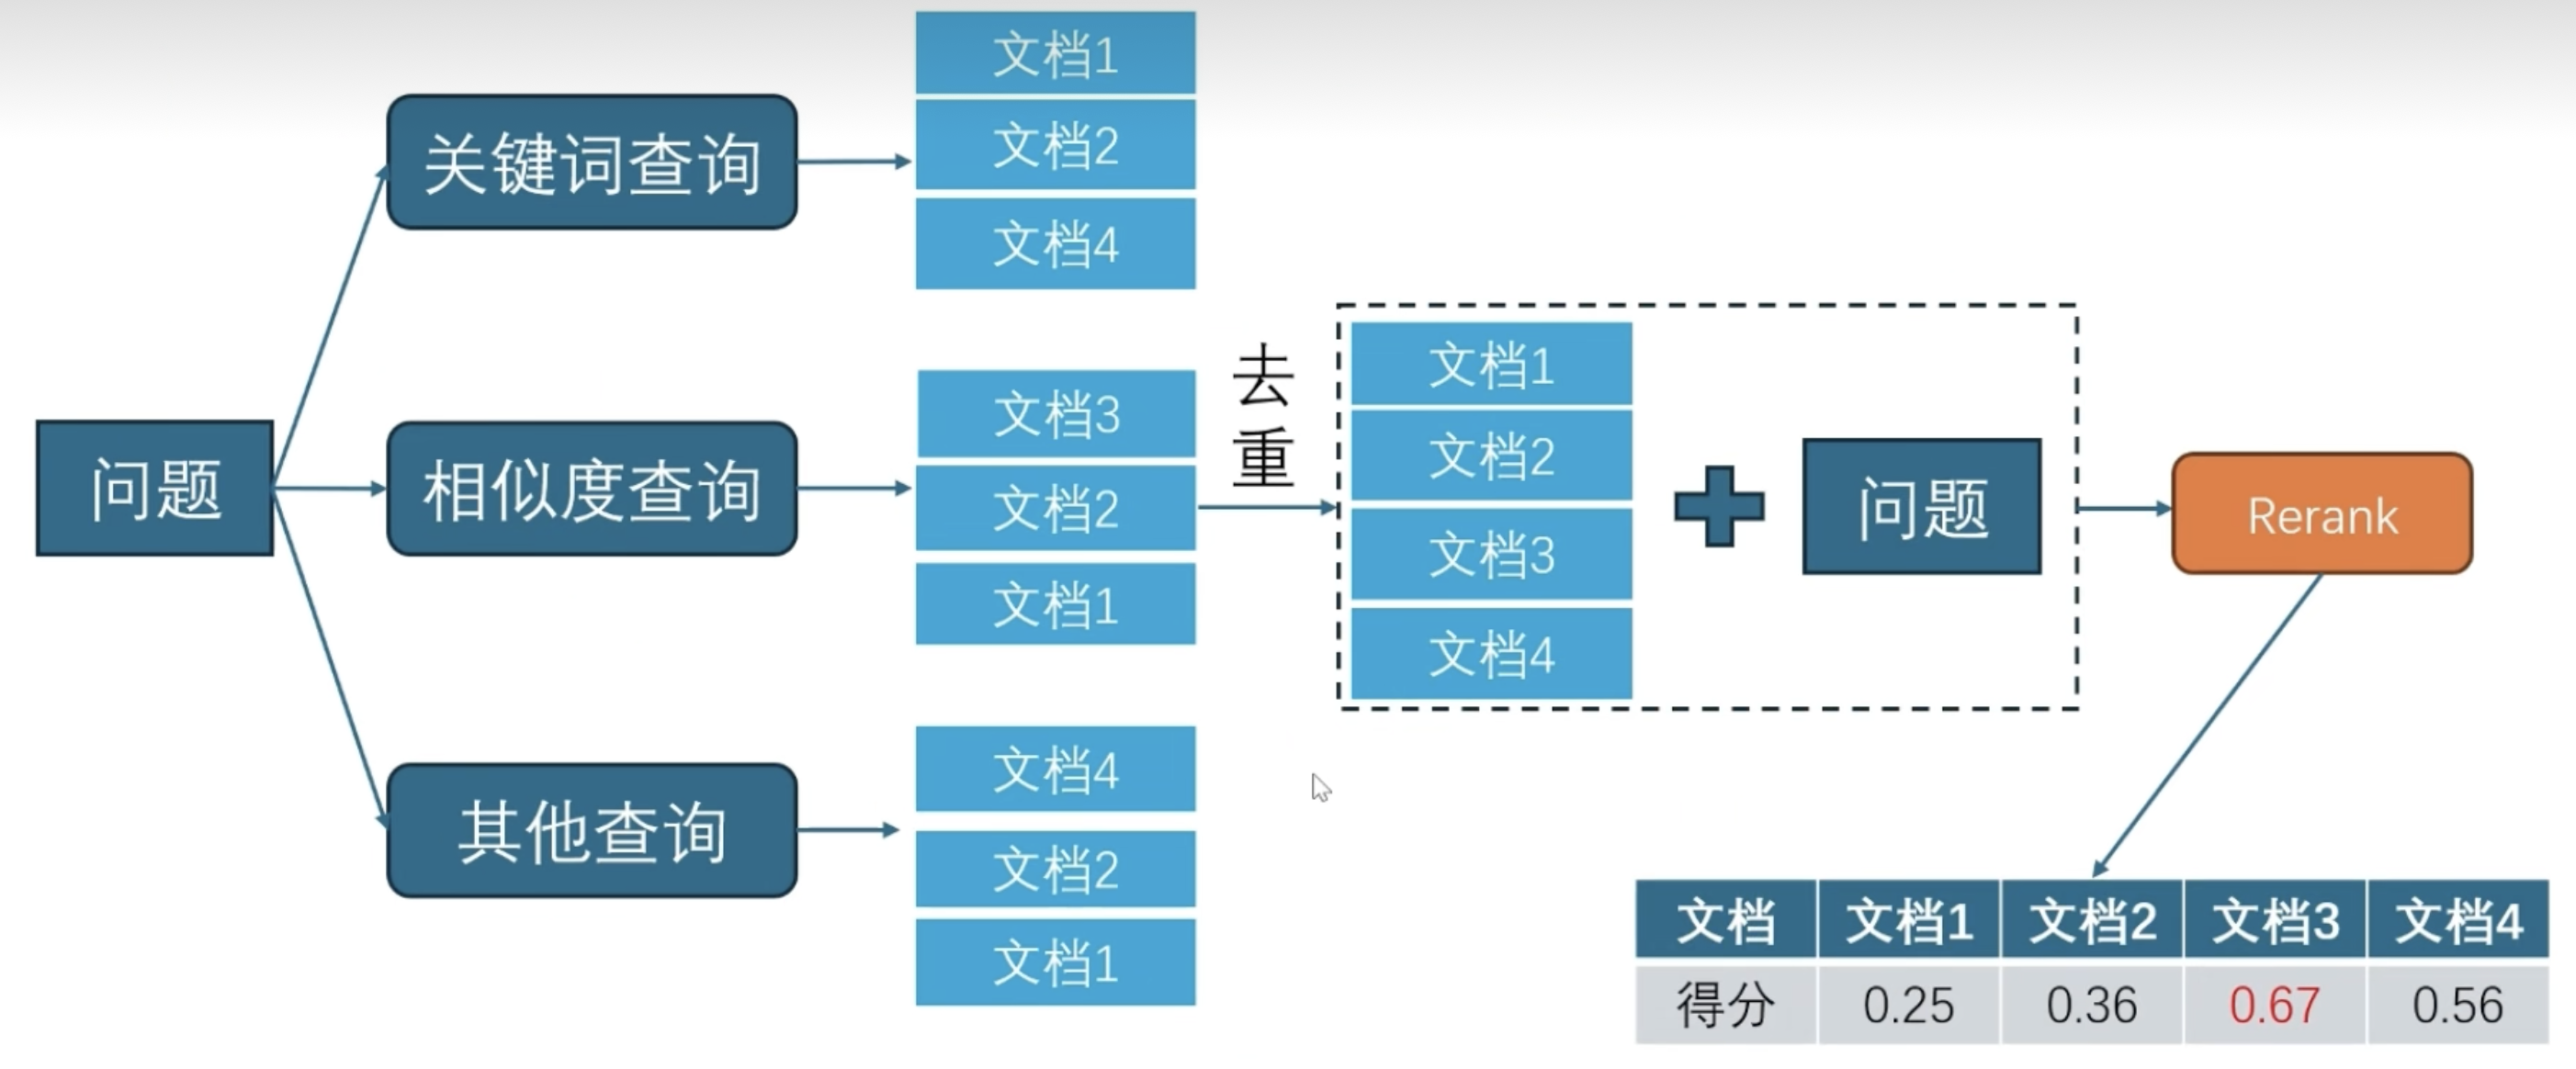
3.2.检索优化——多路召唤
3.3.检索优化——Rerank
这是多路召唤的一种,需要借助rerank模型来实现。
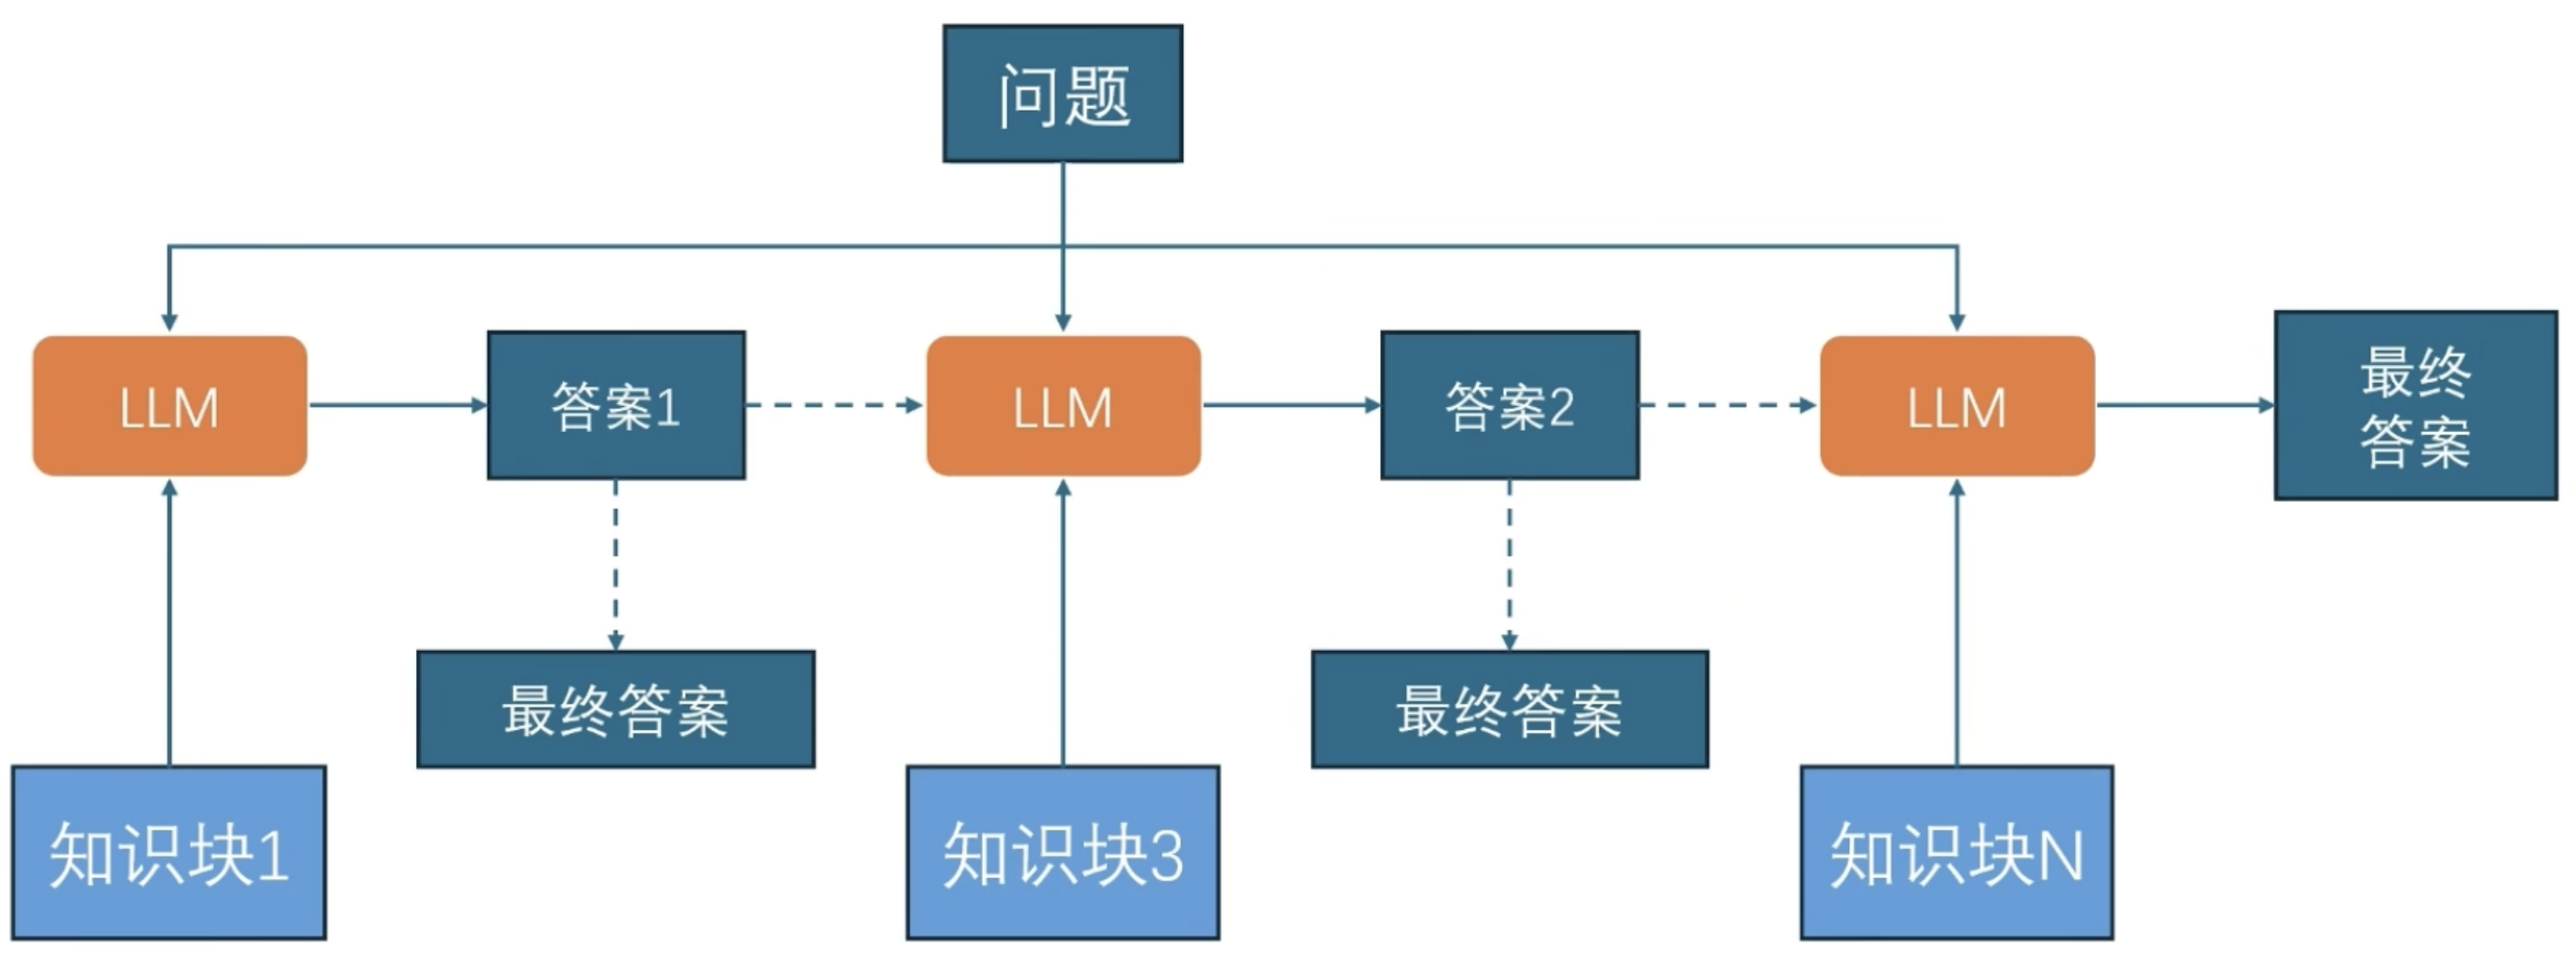
3.4.生成优化——refine模式
结合不同的知识块生成答案,直到最终答案。
3.5.合理利用元数据
什么是元数据: 对文档的描述,如类型、作者、创建日期、来源等
检索前过滤: 如,剔除无关文档、检索最近文档
检索中评估相关性: 如,重要文档给予更高的权重加成
检索后重排:如,重要文档排前面
生成时提升用户体验: 提供参考文档来源,增加可信度
4.评估RAG
4.1.RAG的评估标准
准确率:站在用户视角,直接评判答案是否符合实际需求
忠实度:生成的内容是否忠实于提供的上下文或背景信息
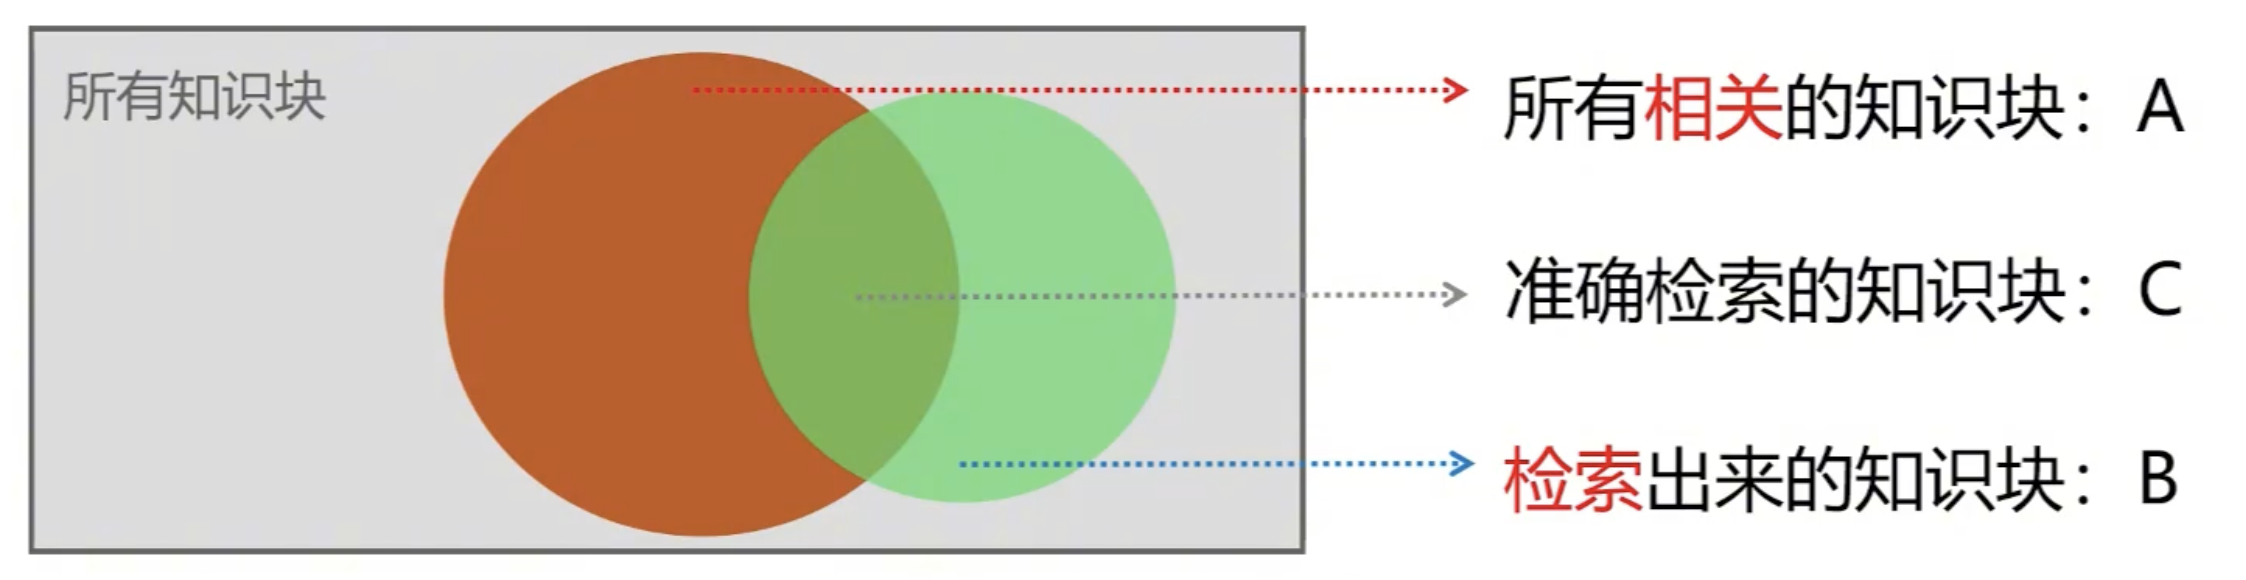
召回率=C/A:参考下图
精准率=C/B:参考下图
F1=2*召回率*精准率/(召回率+精准率)
4.2.RAG的评估方法
有两种评估方法
(1)人工评估
准备测试样本,包含问题、标准答案、评分标准
执行测试,得到作答结果
人工交叉评估、评估每个回答准确 or 错误或者对每个回答评分
统计准确率,或者统计得分
(2)模型自动评估
准备测试样本,包含问题、标准答案
执行测试,得到作答结果
模型评估方法1: 将问题+作答结果输入Rerank模型,得到两者的相关性作为得分
模型评估方法2: 评估标准答案和作答结果的文本相似度,得到结果作为评分
统计得分
4.3.可利用的工具和技术
(1)善用大模型
生成样本。如评估检索成效时,基于知识块生成问题,形成多个问题 - 上下文映射列表,应用时,输入问题得到检索结果,与原来的知识块比较,从何评估检索成效
评估成效
(2)善用评估框架
LangSmith 平台
Langfuse 平台
Rags 框架