Lance 支持的索引类型可以分成 标量索引 和 向量索引 两大类。
Lance标量索引
从 IndexType 支持的标量索引有:
BTREE / BTree
通用精确查找、范围过滤常用索引
BITMAP / Bitmap
适合低基数、枚举值类过滤
LABEL_LIST / LabelList
适合数组标签类字段,例如 array_has_any
INVERTED / Inverted
倒排索引,主要用于全文检索 FTS
NGRAM / NGram
n-gram 文本包含查询索引
ZONEMAP / ZoneMap
min/max 跳过类索引
BLOOMFILTER / BloomFilter
布隆过滤器索引
RTREE / RTree
空间索引,Rust 内部 IndexType 中存在
JSON
JSON 字段索引,本质是对 JSON 路径上的目标字段建立底层索引,例如 target_index_type="btree"
FragmentReuse
这是内部索引
MemWal
这是内部索引
Lance向量索引
向量索引底层可以理解为由多个 stage 组合而成,例如:
IVF_PQ = IVF 分区 + Product Quantization
IVF_FLAT = IVF 分区 + 原始向量精确/近似扫描
IVF_SQ = IVF 分区 + Scalar Quantization
IVF_HNSW_PQ = IVF + HNSW 子索引 + PQ
IVF_HNSW_SQ = IVF + HNSW 子索引 + SQ
IVF_HNSW_FLAT = IVF + HNSW 子索引 + Flat
IVF_RQ = IVF + Residual Quantization
当前 IndexType 中支持的向量索引包括:
IVF_PQ
IVF_PQ 全称是 Inverted File with Product Quantization,是 Lance 中面向大规模向量相似度检索的经典 ANN 索引类型。
它由两部分核心技术组合而成:
(1)IVF:Inverted File,倒排文件/聚类分区索引,用 K-Means 把全量向量划分到多个 partition,也叫 cluster、cell、bucket。
(1)PQ:Product Quantization,乘积量化 把高维向量切成多个子向量,每个子向量单独量化成一个较小的 code,从而显著压缩存储和加速距离计算。
因此,IVF_PQ 的目标是:
(1)用 IVF 减少搜索范围
(2)用 PQ 压缩向量存储
(3)用近似距离计算提升吞吐
(4)用 nprobes 和 refine_factor 在延迟与召回之间调节
IVF 的作用
IVF 负责 粗粒度召回候选集合。
构建时:
(1)从数据中采样训练集。
(2)使用 K-Means 训练出 num_partitions 个中心点。
(3)每条向量找到最近的中心点。
(4)向量被分配到对应 partition。
查询时:
(1)查询向量先和所有 IVF centroids 计算距离。
(2)找出最近的前 nprobes 个 partition。
(3)只搜索这些 partition 内的向量,而不是扫全表。
案例
num_partitions = 256
nprobes = 20
表示查询时只搜索 256 个 partition 中最接近查询向量的 20 个。
nprobes这会明显影响搜索数据量。
nprobes 越大:召回越高;查询越慢;扫描的数据越多。
nprobes 越小:查询越快;召回可能下降。
PQ 的作用
PQ 负责 压缩向量并加速近似距离计算。核心思想是把一个高维向量切成多个子空间。
原始向量 x = [x_0, x_1, ..., x_127]

如果 num_sub_vectors = 16,则切成:

subvector_0:  x[0:8]
subvector_1:  x[8:16]
...
subvector_15: x[120:128]
每个子空间独立训练一个 codebook。
如果 num_bits=8,每个子空间有 2^8 = 256 个 centroid/codeword。编码时,每个子向量只记录它最接近哪个 codeword。
所以一个向量不再存完整 float 数组,而是存:
__pq_code = [12, 87, 33, ..., 201]每个 code 通常是 uint8。
生成IVF_PQ索引的过程
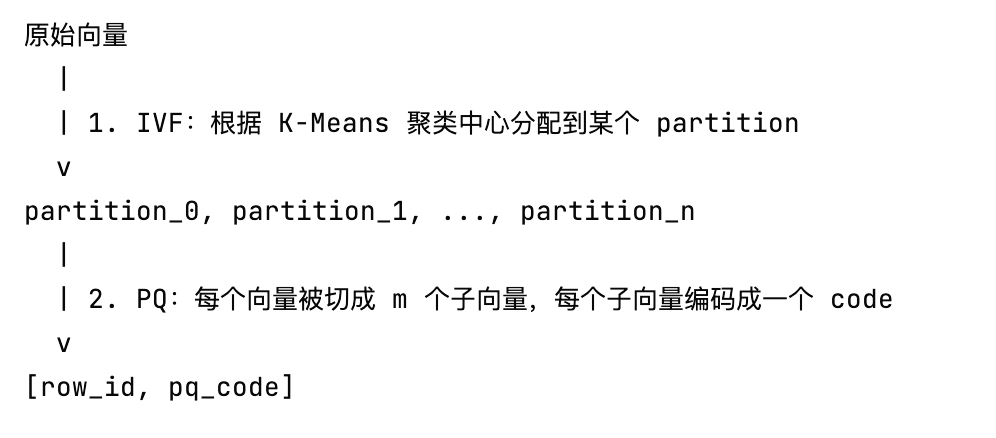
为一个原始向量生成索引,IVF_PQ 会做两层处理,如下图所示:
具体可分为如下流程
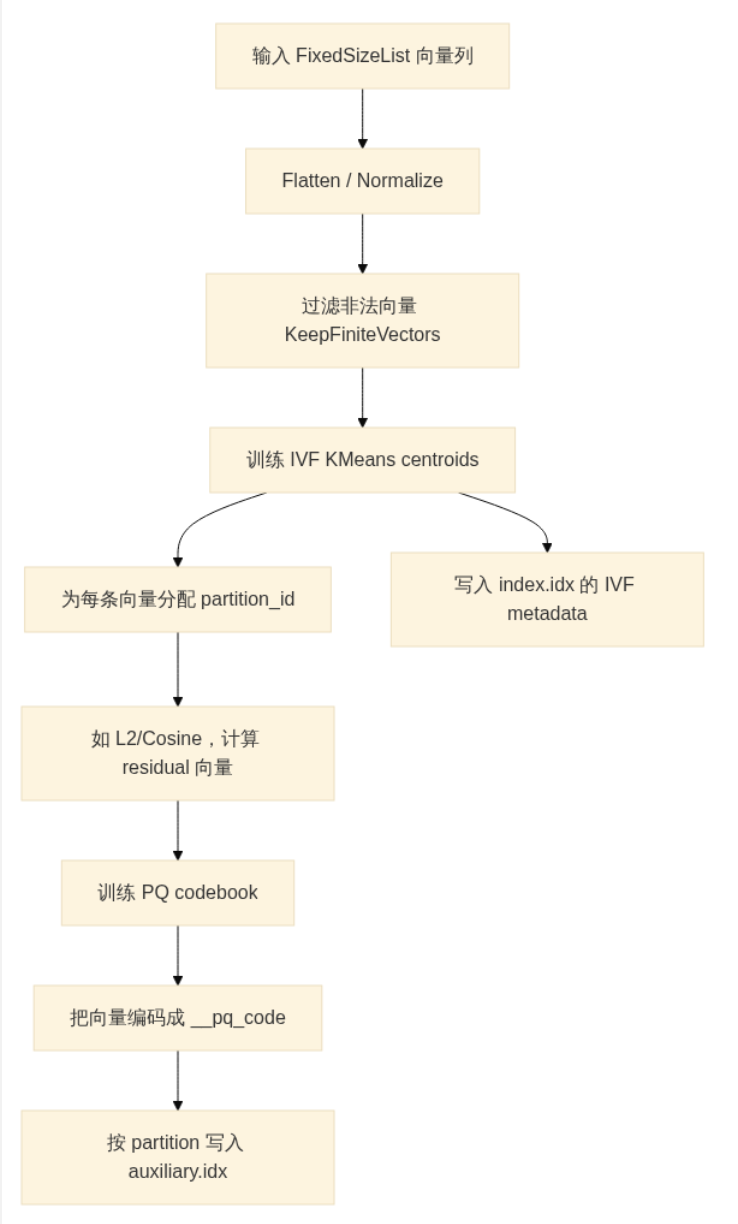
Cosine 距离会先 normalize,然后内部可转成 L2 处理。
L2 / Cosine 下,PQ 会使用 residual,也就是:
residual = vector - centroid_of_partition这样 PQ 量化的是向量相对于所属 IVF centroid 的残差,通常精度更好。
创建索引的方式如下所示:
ds.create_index(
    "vector",
    index_type="IVF_PQ",
    num_partitions=256,
    num_sub_vectors=16,
)
主要构建参数
(1)num_partitions
IVF partition 数量。
作用:控制 K-Means 聚类中心数量;控制向量被划分成多少个 inverted list;影响构建时间、查询速度和召回。
num_partitions如果太大,K-Means 构建更慢,partition 可能过碎,召回调参更敏感。
num_partitions如果太小,每个 partition 太大,查询扫描量大。
(2)num_sub_vectors
PQ 子向量数量,通常记作 (m)。
num_sub_vectors 越大:PQ code 更长;压缩率下降;量化误差降低;召回通常更好。
num_sub_vectors 越小:压缩率更高;内存/磁盘更省;量化误差更大;召回可能下降。
(3)num_bits
每个子向量 code 使用多少 bit。默认为8。
(4)metric
距离度量。
常见值:L2、Cosine、Dot
查询时也可以指定 metric,通常应与建索引时一致。
(5)max_iters
K-Means 最大迭代次数。
默认值为50。
(6)sample_rate
训练采样率。
默认值为256。
在 PQ 中,样本量逻辑大致是:
sample_size = sample_rate * 2^num_bitsIVF_PQ查询流程
IVF_PQ 查询大致如下
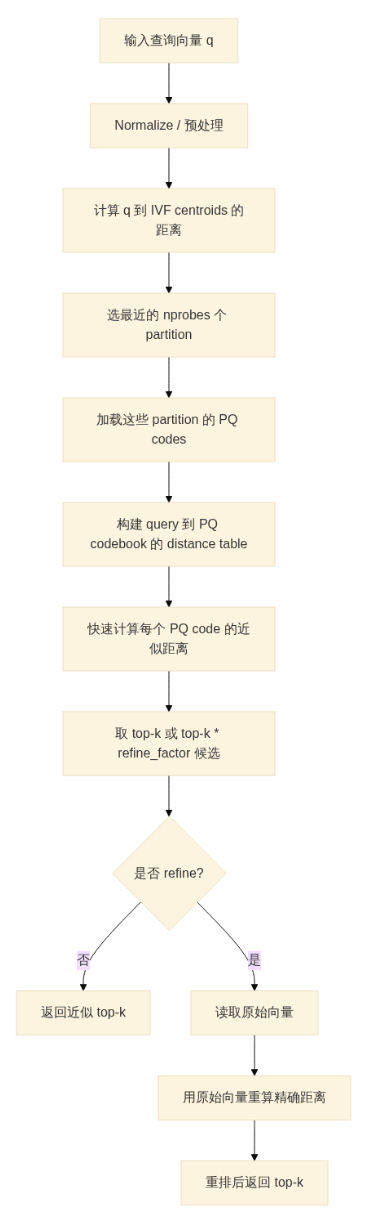
Lance 中的物理存储结构
Lance V3 向量索引由两个 Lance 文件组成:index.idx和auxiliary.idx
index.idx
index.idx 存索引结构和 IVF metadata。IVF metadata 包含
centroids_tensor: [num_partitions, dimension]
offsets: 每个 partition 在 auxiliary.idx 中的起始位置
lengths: 每个 partition 的向量数量
loss: K-Means loss,可选
auxiliary.idx
auxiliary.idx 存实际的量化向量数据。
对于 IVF_PQ,其核心列类似:
pa.schema([
    pa.field("_rowid", pa.uint64()),
    pa.field("__pq_code", pa.list(pa.uint8(), list_size=m)),
])
其中:
_rowid:原始数据行 ID
__pq_code:PQ 编码后的向量 code
m:num_sub_vectors
IVF_PQ 的精度和性能取舍
影响 IVF_PQ 效果的核心参数有 4 个。
(1)num_partitions 越大,会导致:
单个 partition 更小。
查询扫描更少。
但训练成本更高。
如果 nprobes 太小,可能漏召回。
(2)nprobes越大,会导致:
搜索更多 partition。
召回率更高。
查询更慢。
(3)num_sub_vectors 越大,会导致:
PQ code 更长。
每个子向量维度更低。
量化误差通常更小。
存储和计算成本增加。
(4)refine_factor 越大,会导致:
精排候选更多。
召回更高。
需要更多回表和精确距离计算。
IVF_PQ 的优缺点
主要如下4个优点:
(1)存储极省:float32[128] 从 512 bytes 压到 16 bytes 左右。
(2)查询快:只查 nprobes 个 IVF partition。每个向量只做 PQ 查表求和。
(3)适合大规模向量检索:百万、千万、亿级向量都适合。
(4)可以 refine 提升精度:先快召回,再用原始向量精排。
有如下3个缺点:
(1)近似搜索:PQ 会引入量化误差。IVF 也可能因为 partition 选择漏召回。
(2)参数敏感:num_partitions、nprobes、num_sub_vectors、refine_factor 都会影响效果。
(3)建索引成本较高:IVF 要 k-means。PQ 每个子空间也要 k-means。
为什么 IVF_PQ 快
主要快在三个地方:
(1)IVF 减少候选数量
不扫全量向量,只扫少数 partition:
全量 1,000,000 条
num_partitions = 256
nprobes = 20

理论上平均只扫:
1,000,000 * 20 / 256 ≈ 78,125 条
(2)PQ 压缩向量
原始 float32 向量
dimension = 768
存储大小 = 768 * 4 = 3072 bytes
PQ code:
num_sub_vectors = 96
num_bits = 8
存储大小 = 96 bytes
压缩比约:
3072 / 96 = 32x(3)PQ 距离计算快
查询时不会对每个候选向量逐维计算完整距离,而是先构建 distance table:
distance_table[subvector_id][codeword_id]然后每个候选向量的距离近似为:
sum(distance_table[i][pq_code[i]] for i in 0..m)也就是把高维向量距离计算变成若干次表查找和累加。
为什么 IVF_PQ 是近似索引
误差主要来自两层:
(1)IVF 只搜索部分 partition
如果真实最近邻落在没被 nprobes 选中的 partition,就会漏召回。
(2)PQ 量化有误差
PQ code 只是原始向量的压缩表示,距离是近似距离。
所以 IVF_PQ 的结果不保证和 brute-force 完全一致。
提升召回的方式主要是:
增大 nprobes
增大 num_sub_vectors
使用 refine_factor
合理选择 num_partitions
使用更高质量训练样本
对 Cosine 场景确保向量归一化逻辑一致
IVF_PQ案例
下面通过案例讲解IVF_PQ索引和查询过程
(1)准备数据
数据量:1,000,000
向量维度:128
(2)准备索引配置
num_partitions:256
num_sub_vectors:16
num_bits:8
distance_type:L2
(3)建索引阶段
1. 从 100 万向量中采样训练数据。

2. 训练 IVF:
   - 在 128 维空间中跑 k-means。
   - 得到 256 个 IVF centroid。

3. 分配 partition:
   - 每个向量找到最近 IVF centroid。
   - 得到 partition id。

4. 计算 residual:
   - residual = vector - IVF centroid。

5. 训练 PQ:
(4)查询阶段
1. 输入 query vector。

2. 找 IVF partition:
   - 计算 query 到 256 个 IVF centroid 的距离。
   - 选最近 nprobes 个 partition,例如 10 个。

3. 对每个 partition:
   - query_residual = query - partition_centroid。
   - 构造 PQ distance table,大小 16 × 256。
   - 扫描该 partition 中所有 __pq_code。
   - 每个向量只做 16 次查表加法。

4. 合并所有 partition 的候选结果。
参数选择建议
(1)针对小数据集
如果数据量不大,例如几万到几十万:
num_partitions = 64 或 128
num_sub_vectors = dimension // 8
nprobes = 8 ~ 32
refine_factor = 5 ~ 20
如果非常小,甚至可以不用 IVF_PQ,直接 IVF_FLAT 或 brute-force 可能更简单。
(2)百万级数据
例如 1M 向量:
num_partitions = 256 或 512
num_sub_vectors = dimension // 8
nprobes = 20 ~ 50
refine_factor = 5 ~ 20
(3)高维 embedding
例如 OpenAI embedding 常见 1536 维:
num_partitions = 256 / 512 / 1024
num_sub_vectors = 96 / 192
num_bits = 8
IVF_FLAT
IVF_SQ
IVF_HNSW_FLAT
IVF_HNSW_SQ
IVF_HNSW_PQ
IVF_RQ
VECTOR
历史兼容别名,当前等价/别名倾向于 IVF_PQ
Lance表向量检索过程
Lance 表做向量检索时,本质上是一次带有 nearest 条件的 Scanner 查询。它会先把用户请求转换成一个向量查询计划,然后根据是否存在可用向量索引,选择:
(1)有索引:走 ANN 近似检索,例如 IVF_PQ、IVF_HNSW_PQ、IVF_FLAT 等。
(1)无索引 / 禁用索引 / 索引不匹配:回退为全表向量扫描,也就是 brute-force。
(3)有增量未建索引数据:索引数据走 ANN,新追加未索引数据走 flat KNN,最后合并重排。
Lance 表向量检索流程可以概括为:
用户 nearest 查询
  -> 校验向量列、维度、类型
  -> 构造 Query
  -> 创建 DataFusion 执行计划
  -> 判断是否有可用向量索引
      -> 有索引:
          -> 找 IVF partitions
          -> 在 partition 内 ANN 搜索
          -> 得到候选 _rowid + _distance
          -> 可选 refine:读取原始向量精确重排
          -> 如有未索引新增数据,额外 flat 搜索后合并
      -> 无索引:
          -> 扫描向量列
          -> KNNVectorDistanceExec 精确计算距离
          -> TopK 排序
  -> 根据 _rowid 回表读取请求列
  -> 返回 Arrow Table / RecordBatch
用户发起向量查询
例如
scanner = ds.scanner(
    nearest={
        "column": "vector",
        "q": query_vector,
        "k": 10,
    },
    filter="category = 'book'",
    prefilter=True,
)
用户传入的 nearest={...} 最终会被转换成 Lance 内部的 Query,Query 对象包含:column、key、k、minimum_nprobes、maximum_nprobes、refine_factor、metric_type、use_index等字段。
创建查询计划
之后 Scanner 会调用 create_plan() 生成执行计划。
简化逻辑如下:
Scanner.create_plan()
  |
  |-- 如果有 nearest
  |      -> vector_search_source()
  |
  |-- 如果有 full_text_query
  |      -> fts_search_source()
  |
  |-- 否则
         -> 普通 scan / filtered scan
查找是否有可用向量索引
Lance 会检查当前表上是否有该向量列的索引
查询时会判断:
是否有这个列上的向量索引
索引覆盖的 fragment 是否非空
用户是否禁用了索引,例如 use_index=False
查询 metric 是否和索引 metric 兼容。如果索引是 cosine,查询却指定 l2,会回退 brute-force。
是否是 multivector 类型
如果找到匹配索引,就进入 ANN 路径。如果没有可用索引,就进入 flat KNN 路径。
有索引时:ANN 检索流程
以 IVF_PQ 为例,整体流程可以理解为:
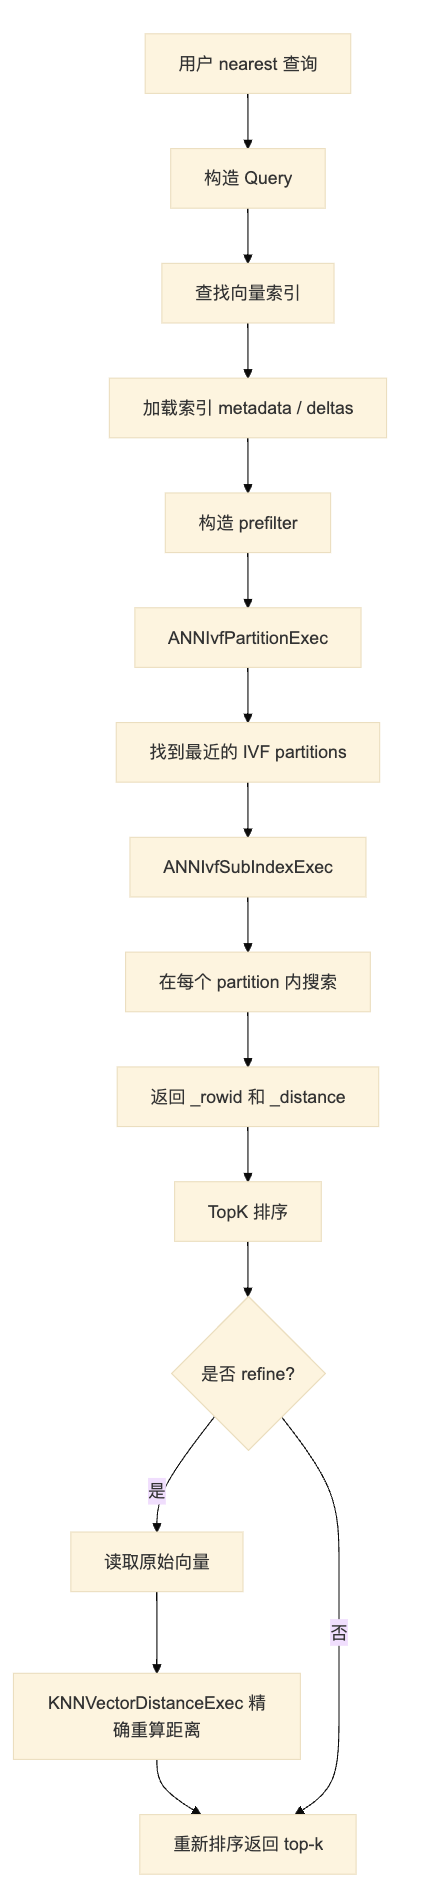
ANNIvfPartitionExec:先找 IVF 分区
在 knn.rs 中,ANNIvfPartitionExec 负责第一阶段:根据查询向量,找到最相关的 IVF partitions。
它会打开向量索引。如果索引 metric 是 Cosine,会对查询向量做 normalize。调用索引的 find_partitions()。
返回:
(1)__ivf_part_id
(2)查询向量到 centroid 的距离 dist_q_c
(3)index uuid
例如
{
  "__ivf_part_id": [3, 18, 27, ...],
  "__dist_q_c": [0.12, 0.15, 0.21, ...],
  "__index_uuid": "..."
}
这里的分区数量受 nprobes 控制。
ANNIvfSubIndexExec:在分区内搜索
ANNIvfSubIndexExec 负责第二阶段:在 ANNIvfPartitionExec 找到的 partitions 内执行实际向量搜索。
执行以下操作:
(1)接收前一步输出的 partition 列表。
(2)打开对应的向量索引。
(3)对每个 partition 调用search_in_partition(...)
返回候选结果:
_distance
_rowid
对于不同索引类型,search_in_partition 的内部实现不同:
IVF_FLAT:在 partition 内用原始向量精确算距离。
IVF_PQ:在 partition 内用 PQ code 近似算距离。
IVF_SQ:用 Scalar Quantization 近似算距离。
IVF_HNSW_*:在 partition 内用 HNSW 搜索。
IVF_RQ:用 RabitQ 量化搜索。
所以对 IVF_PQ 来说,这一步会读取 PQ 编码后的数据,使用 codebook 构造距离表,然后快速估算距离。
nprobes 的执行细节
Lance 内部支持两个相关参数:minimum_nprobes和maximum_nprobes。普通 nprobes 会同时设置这两个值。
流程大致是:
先搜索 minimum_nprobes 个 partition
  |
  |-- 如果已经找到足够 k 个结果
  |      -> 可以提前结束
  |
  |-- 如果结果不足,并且允许 maximum_nprobes
         -> 继续搜索更多 partition
例如过滤条件很严格:
ds.scanner(
    nearest={"column": "vector", "q": q, "k": 10},
    filter="category = 'rare'",
    prefilter=True,
)
如果前几个 partition 中满足过滤条件的结果不足,Lance 可以继续搜索更多 partition,尽量补齐 k 个结果。
过滤条件如何参与向量检索
如果查询同时带有向量检索和标量过滤,例如
ds.scanner(
    nearest={"column": "vector", "q": q, "k": 10},
    filter="category = 'book'",
    prefilter=True,
)
Lance 会构造 prefilter_source。
它可能来自:
标量索引查询结果。例如 BTREE、BITMAP、INVERTED 等。
过滤扫描得到的 _rowid 集合
无过滤条件
如果 prefilter=True,逻辑更接近:先找出满足 filter 的 row_id;再在这些 row_id 范围内做向量搜索。
优点:结果语义更准确。能保证是在过滤后的集合里找 top-k。
缺点:如果过滤本身很贵,可能增加开销。
如果 prefilter=False,逻辑更接近:先做向量 top-k / ANN 搜索;再应用 filter。
优点:通常更快。
缺点:最终结果可能少于 k。对强选择性过滤条件可能召回不好
refine_factor:读取原始向量重排
如果使用 IVF_PQ 这类量化索引,初始距离是近似距离。
所以 Lance 支持 refine:
ds.to_table(
    nearest={
        "column": "vector",
        "q": q,
        "k": 10,
        "nprobes": 20,
        "refine_factor": 10,
    }
)
含义是:
先用 ANN 找 k * refine_factor 个候选,例如 10 * 10 = 100 个候选。
然后读取这 100 个候选的原始向量。用真实距离重新计算,最后返回 top-10。
在执行计划上表现为:
ANNSubIndex
  ANNIvfPartition
Take: 读取原始 vector
KNNVectorDistance: 精确重算距离
SortExec: TopK
KNNVectorDistanceExec 的职责就是:
接收包含原始向量列的输入 batch。
对每一行向量计算和查询向量的距离。
添加 _distance 列。
过滤掉 NaN 距离。
输出供后续排序。
没有索引时:Flat KNN 全表扫描
如果没有可用向量索引,或者指定:
nearest={
    "column": "vector",
    "q": q,
    "k": 10,
    "use_index": False,
}
Lance 会走 flat KNN。流程如下
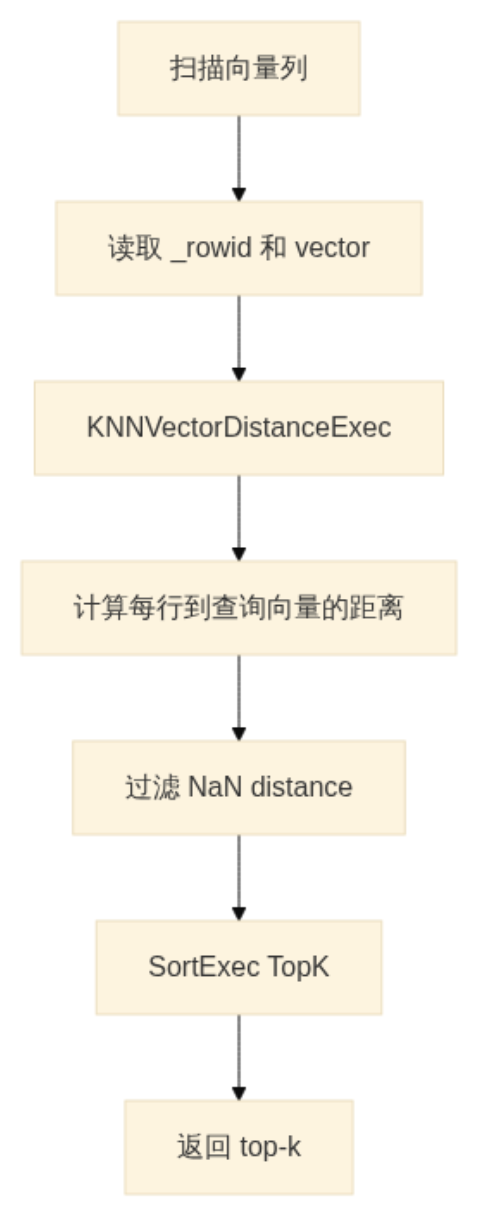
执行计划中一般会看到:
LanceScan
  -> KNNVectorDistance
  -> SortExec TopK
这个路径是精确搜索,但需要扫描所有候选向量,所以数据量大时会慢。
索引数据 + 新增未索引数据的混合检索
Lance 表可能持续 append 数据。
如果索引是在某个时间点创建的,那么后面新增的 fragment 可能还没有被索引覆盖。
这时如果不是 fast_search,Lance 会做混合搜索:
已建索引 fragments
  -> ANN 搜索

未建索引 fragments
  -> Flat KNN 搜索

两边结果 union
  -> 再做一次 KNN / TopK 合并排序
这对应 scanner.rs 里的 knn_combined 逻辑。
这样可以保证:
老数据利用索引加速
新数据不会漏查
最终结果在两部分之间重新排序
如果用户调用的是 fast_search(),则只查索引覆盖的数据,不查未索引的新数据。
最终取列与结果返回
向量检索的中间结果通常只有:_rowid和_distance。
如果用户还请求了其他列,例如:
ds.to_table(
    nearest={"column": "vector", "q": q, "k": 10},
    columns=["id", "text"]
)
Lance 会在得到 _rowid 后,通过 TakeExec 回表读取需要的列:
ANN / KNN 得到 _rowid
  -> TakeExec 根据 _rowid 读取 id、text 等列
  -> ProjectionExec 做最终投影
  -> 返回 Arrow Table / RecordBatch
所以向量检索通常是两阶段:
先找候选 row id
再根据 row id 回表取用户需要的列
一个典型执行计划
有 IVF_PQ 索引、开启 refine、同时存在未索引新增数据时,执行计划可能近似是:
ProjectionExec
  Take: columns="id, text"
    FilterExec: _distance IS NOT NULL
      SortExec: TopK
        KNNVectorDistance
          RepartitionExec
            UnionExec
              Flat KNN over unindexed fragments
              Take original vector
                SortExec: TopK
                  ANNSubIndex
                    ANNIvfPartition
可以理解为:
ANNIvfPartition:找 IVF 分区。
ANNSubIndex:在分区内做 ANN。
SortExec TopK:取候选 top-k 或 k * refine_factor。
Take original vector:回表读原始向量。
KNNVectorDistance:refine 精确算距离。
UnionExec:合并未索引新增数据。
Take:读取最终用户需要的列。
ProjectionExec:输出最终结果。
Lance 中的关键约束
总结了以下约束
(1)维度必须能被 num_sub_vectors 整除,因为 PQ 要把向量均匀切成多个子向量
dimension % num_sub_vectors == 0(2)SIMD 对齐建议,否则建索引可能明显变慢。
(dimension / num_sub_vectors) % 8 == 0(3)训练数据量至少要大于 centroid 数