1.RDD
RDD(Resilient Distributed Dataset,弹性分布式数据集) 是 Spark 最核心的数据抽象,可以理解为「分布在集群多台机器上的、只读的、可分区的、可容错的数据集合」。
Resilient(弹性/容错):通过血缘(Lineage)机制,某个分区丢失后可自动重算恢复,无需像 Hadoop 那样做数据复制或检查点
Distributed(分布式):数据分布在集群多个节点上,天然支持并行计算
Dataset(数据集):一个只读的数据集合,不可变(Immutable)
1.1.RDD的核心特性
一个 RDD 本质上由以下五个属性构成(对应源码中的 RDD 抽象类):
1.2.RDD的核心特点
RDD包含以下四个核心特点:
(1)只读、不可变(Immutable)
RDD 一旦创建就不能修改。任何「转换」操作(如 map、filter)都会生成一个新的 RDD,而不是修改原 RDD。
(2)惰性求值(Lazy Evaluation)
转换操作(Transformation)不会立即执行,只是记录计算逻辑;只有遇到行动操作(Action,如 count、collect、save)时才真正触发计算。
(3)血缘与容错(Lineage)
RDD 记录了它是如何从父 RDD 一步步转换来的(依赖链)。某个分区的数据丢失时,可以沿着血缘链重新计算该分区,而不是从头重跑整个作业。
(4)内存计算
数据优先缓存在内存中(配合 persist/cache),避免反复读写磁盘,这是 Spark 比 MapReduce 快的重要原因。
1.3.RDD算子类型
RDD的compute函数可分为以下两种算子:
(1)转换操作算子 Transformation
返回新的 RDD,惰性执行,不触发计算,包括:map / filter / flatMap / reduceByKey / groupByKey……
(2)行动操作算子 Action
返回结果或写出数据,触发真正的计算,包括:count / collect / reduce / saveAsTextFile / foreach……
1.4.RDD依赖类型
RDD依赖类型分为两种:
(1)窄依赖(Narrow Dependency)
父 RDD 的每个分区,最多被一个子 RDD 分区使用。可以在同一个 Stage 内流水线(Pipeline)执行,无需 Shuffle。
例如:map、filter、union
(2)宽依赖(Wide/Shuffle Dependency)
父 RDD 的一个分区,会被多个子 RDD 分区使用。必须产生 Shuffle,成为 Stage 的切分边界。
例如:reduceByKey、groupByKey、join
2.Spark vs Flink vs MapReduce
三种计算引擎的定位不同
计算引擎核心维度对比
不同计算引擎的适用场景如下表所示:
选型要点总结
(1)纯离线批处理 + 需要丰富生态(SQL/ML/Graph) → Spark
(2)实时流处理 / 低延迟 / Exactly-Once / 复杂事件时间 → Flink
(3)大规模离线 + 追求极致稳定性 + 资源受限 / 历史系统 → MapReduce
(4)流批一体统一平台 → 优先 Flink(技术趋势),若团队已有 Spark 生态可继续用 Spark Structured Streaming 过渡
3.Spark数据本地性调度
Spark 通过 getPreferredLocations 让每个 RDD 分区声明"我最好在哪里读",调度器用五级本地性 + 延迟调度在"等待更本地资源"和"及时启动任务"之间做权衡,把任务尽量"黏"在数据旁;任务运行时,读取器再按 executorId/host 分流,本地块直接读磁盘/内存,只有真正跨节点的块才走网络。两层配合,最大化削减网络 shuffle 与磁盘 I/O。
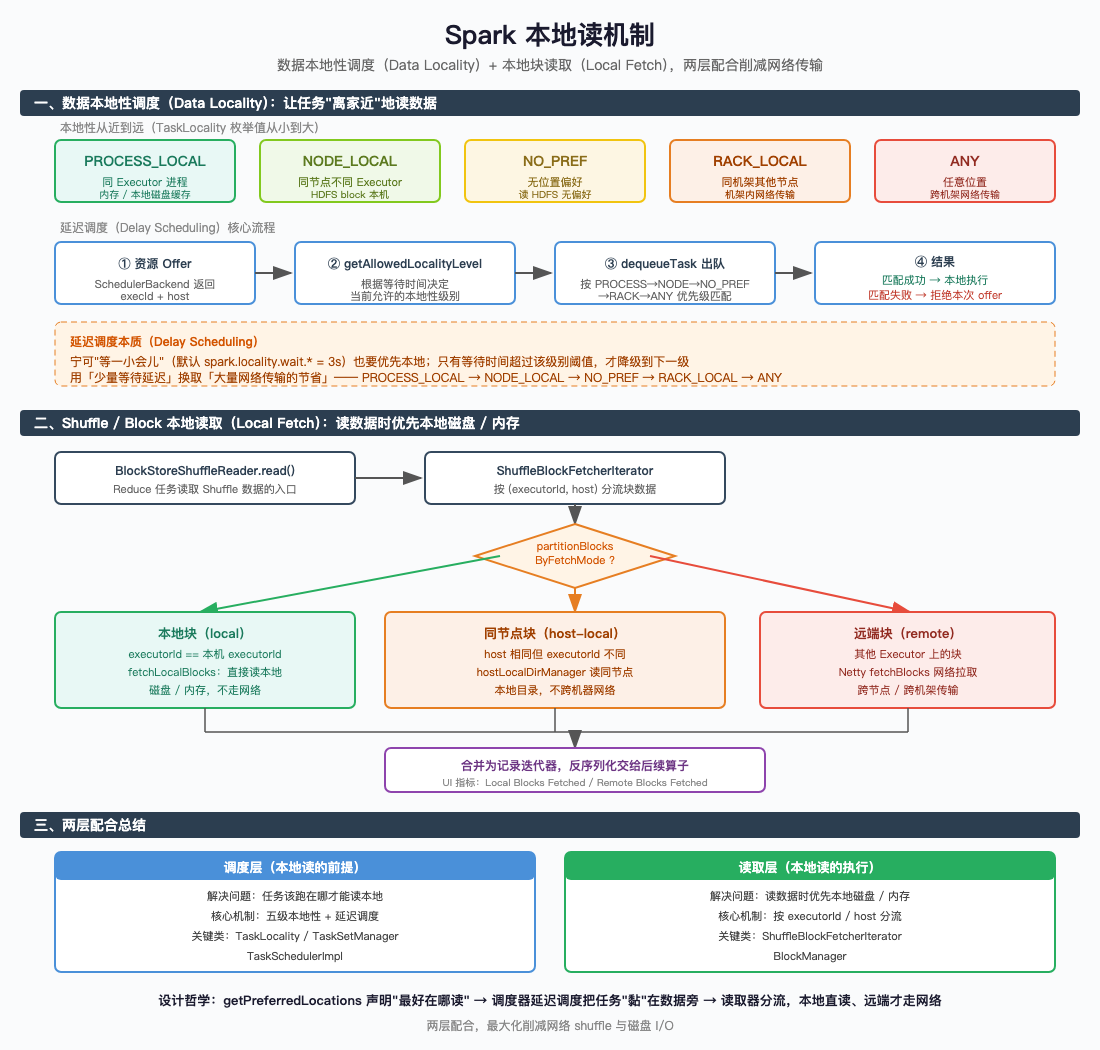
本地块读取(Local Fetch)
入口 BlockStoreShuffleReader.read() → ShuffleBlockFetcherIterator
菱形分流 partitionBlocksByFetchMode,按 (executorId, host) 分成三条路径:
local:executorId == 本机 → 本地磁盘/内存直读,不走网络
host-local:同节点不同 Executor → 同节点本地目录读
remote:其他 → Netty 网络拉取
3.1.本地性级别
本地性有5个级别
3.2.Delay Scheduling(延迟调度)算法
核心就是用「少量延迟」换取「大量网络传输的节省」。
每个本地级别都有一个默认 3 秒的等待窗口。如果当前只有 ANY 级别的资源可用,Spark 会拒绝这次 offer、等待更本地的资源出现;只有当等待时间超过该级别阈值,才降级到更远的级别。
从图上可知,延迟调度四步流程:资源 Offer → 计算允许级别 → 按优先级出队 → 匹配成功本地执行 / 失败则拒绝并等待
4.Spark SQL通用优化方法
Spark SQL 优化本质是围绕一句话展开:减少数据扫描量、减少 Shuffle、避免数据倾斜、提升资源利用率。下面按"从易到难、从通用到进阶"梳理一套可落地的优化方法。
4.1.执行计划层面优化
首先,看执行计划
EXPLAIN COST <SQL>;        -- 看物理计划 + 代价
EXPLAIN EXTENDED <SQL>;    -- 看详细计划(含裁剪、谓词下推)
关注点:是否全表扫描、是否走了 BroadcastHashJoin、Filter 是否下推、是否发生不必要的 Shuffle。
然后,参考核心优化点进行优化。
4.2.Join 优化
这是最常见、收益最大的优化方法。具体的措施如下
(1)优先让小表走广播(BroadcastHashJoin)
使用方法如下
-- 默认 spark.sql.autoBroadcastJoinThreshold = 10MB
-- 小表(<10MB)自动广播;超限时手动 hint
SELECT /*+ BROADCAST(b) */ ... FROM 大表 a JOIN 小表 b ON a.id = b.id;
广播 Join 避免 Shuffle,是收益最大的优化之一
可调大阈值:spark.sql.autoBroadcastJoinThreshold = 100MB(需保证 Driver/Executor 内存够)
(2)避免大表 Join 大表(必要时优化)
用 Skew Join 处理倾斜。
用 Bucket Join(分桶表)减少 Shuffle。
(3)优先用 SortMergeJoin 还是 BroadcastJoin?
可参考下表进行选择
4.3.数据倾斜优化
这是重点和难点,按照以下步骤进行
(1)识别倾斜
可以查看key的分布,如果key分布不均,则必定倾斜。
-- 看 key 分布
SELECT key, count(*) cnt FROM table GROUP BY key ORDER BY cnt DESC LIMIT 10;
或在 Spark UI → Stage → Task 的 Duration 分布,少数 Task 极慢 = 倾斜。
(2)常见解法
根据不同的场景选择解法
(3)开启 AQE(自适应查询执行,强烈推荐)
开启的配置如下:
spark.sql.adaptive.enabled = true                    # 开启 AQE
spark.sql.adaptive.coalescePartitions.enabled = true # 自动合并小分区
spark.sql.adaptive.skewJoin.enabled = true           # 自动处理倾斜 Join
spark.sql.adaptive.skewJoin.skewedPartitionFactor = 5
AQE 是 Spark 3.0+ 的利器,能运行时动态调整分区数、处理倾斜、优化 Join 策略,默认应开启。
4.4.Shuffle 优化
spark难免也会遇到shuffle,可参考以下优化点
4.5.资源配置优化
大部分时候,资源配置可以起到最明显的优化效果
# Executor 配置(按集群资源调整)
spark.executor.memory = 8g
spark.executor.cores = 4
spark.executor.instances = 20
spark.driver.memory = 4g

# 动态资源分配(推荐)
spark.dynamicAllocation.enabled = true
spark.dynamicAllocation.minExecutors = 5
spark.dynamicAllocation.maxExecutors = 50
有以下经验法则:
(1)Executor 核数不宜过多(3~5 核最优,太多会争抢)
(2)内存分三块:执行内存 + 存储内存 + 用户内存(默认 60% 给执行+存储)
(3)开启动态分配,按负载伸缩
4.6.存储格式与文件优化
有以下优化点
4.7.SQL 写法优化
常用的sql写法优化参考下表
例如
-- ❌ 避免
SELECT * FROM t;                          -- 不用列裁剪
SELECT count(*) FROM t GROUP BY 1;        -- 隐式类型转换
WHERE func(col) = x                       -- 列上套函数,阻止下推/索引

-- ✅ 推荐
SELECT col1, col2 FROM t;
WHERE col = x AND dt = '20240101'         -- 条件命中分区字段
4.8.元数据与统计信息优化
统计信息过期是"计划变差"的常见根因(结合之前值班案例)。数据大量变化后,及时 ANALYZE。
-- 更新统计信息(优化器依据它做 CBO 决策)
ANALYZE TABLE t COMPUTE STATISTICS;
ANALYZE TABLE t COMPUTE STATISTICS FOR COLUMNS col1, col2;

-- 开启 CBO(基于代价优化)
spark.sql.cbo.enabled = true
spark.sql.statistics.histogram.enabled = true
4.9.其他高频优化点
其他高频优化点参考下表
5.Spark动态内存分配
如下图所示:
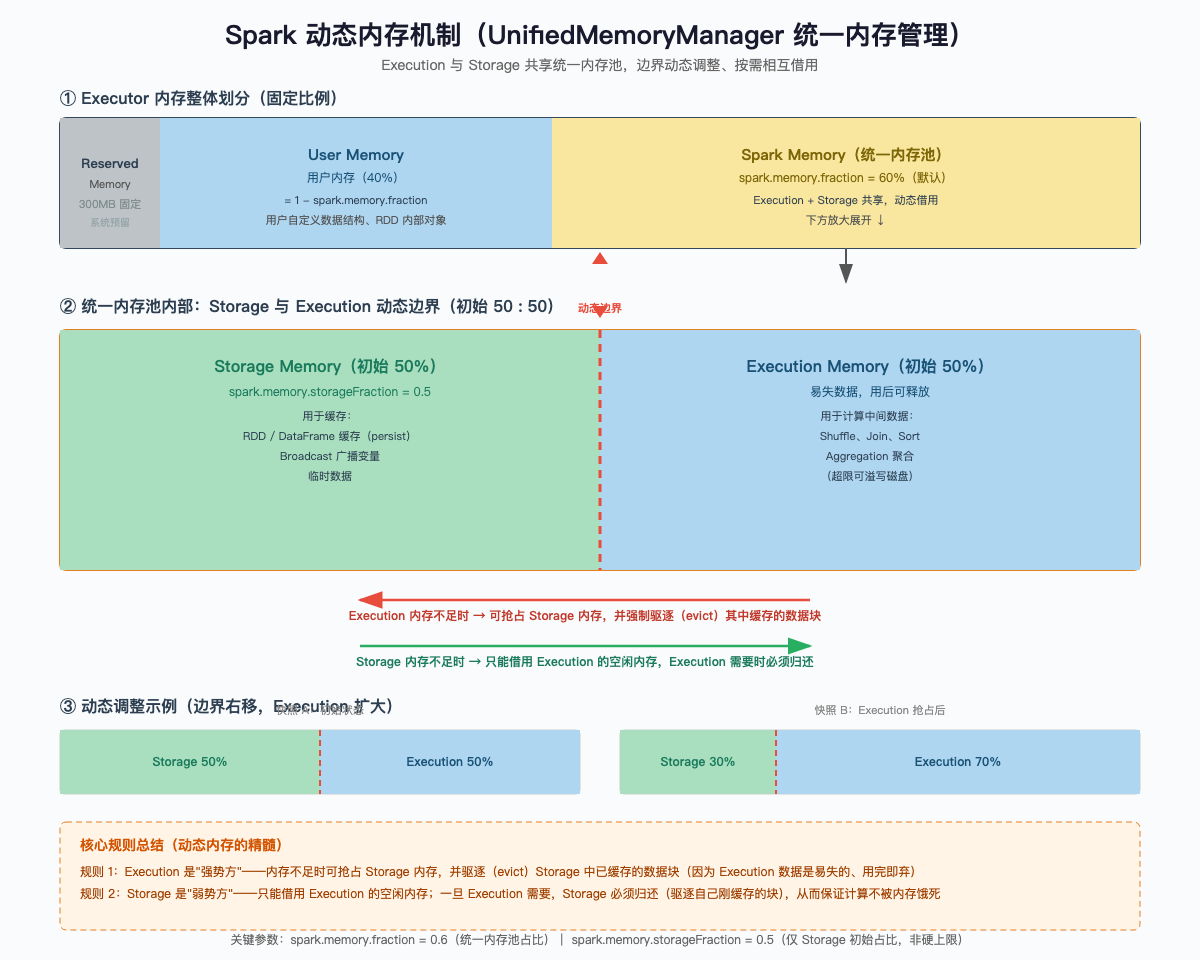
spark.memory.storageFraction = 0.5 只是一个初始占比,不是硬上限——它只在初始阶段划分 Storage 和 Execution 的起点。
Execution 可以无限度抢占 Storage(通过驱逐缓存),因为 Execution 的数据是易失的、用完即弃,优先级最高。
Storage 不能反过来抢占 Execution 已占用的内存,只能捡空闲,且要随时归还——这保证了计算永远不会被缓存"饿死",体现了"计算优先于缓存"的设计哲学。